yura1685
ABC471の解法記事
A - Nine or Nein
四則演算の練習.Nein はドイツ語で No の意味らしい.
a, b = map(int, input().split())
s = {a+b, a-b, a*b, 0 if a % b else a//b}
print('Nine' if 9 in s else 'Nein')
B - Survey Tabulation
大文字列と小文字列を同じとみなすとのことなので,isupper() や islower()を使って統一しましょう.文字列の個数は辞書を使えば簡単に数えられます.
from collections import Counter

N = int(input())
C = Counter(input().upper() for _ in range(N))
print(max(C.values()))
C - Cookies and Greedy Takahashi
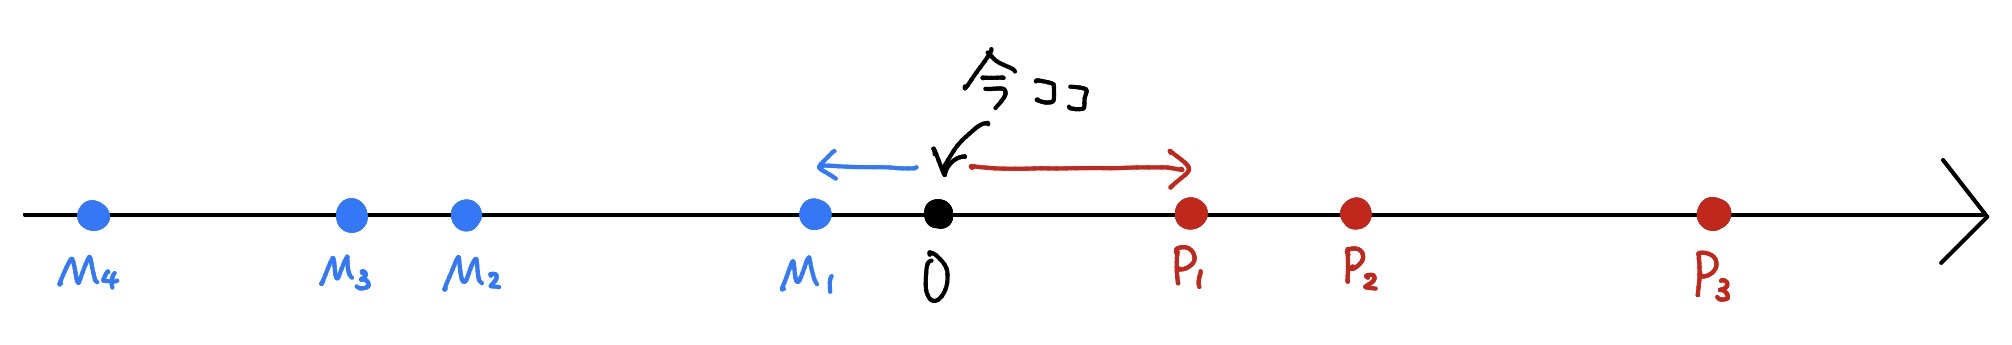
クッキーを正の座標と負の座標に分けます.正の座標は降順,負の座標は昇順にソートしておくと,どちらも配列の末尾が「まだ拾っていないクッキーのうち絶対値が最も小さいもの」になります.そこで,それぞれの末尾にあるクッキーと現在地との距離を比較し,近い方を拾います.距離が等しい場合は座標が小さい負の側を選びます.拾ったクッキーは pop() で削除し,現在地を更新します.これをすべてのクッキーを拾うまで繰り返します.SortedSet で二分探索をやっても良さそうですね.
N = int(input())
A = list(map(int, input().split()))

P, M = [], []
for a in A:
    if a > 0:
        P.append(a)
    else:
        M.append(a)
P.sort(reverse=True)
M.sort()

now = 0
ans = 0

while P or M:
    if P and M:
        p, m = P[-1], M[-1]
        if now - m <= p - now:
            ans += now - m
            now = M.pop()
        else:
            ans += p - now
            now = P.pop()
    elif P:
        p = P[-1]
        ans += p - now
        now = P.pop()
    else:
        m = M[-1]
        ans += now - m
        now = M.pop()

print(ans)
D - Chargers
全てのバッテリーについて時間が経過する度に残量を増やすのは大変なので,「残量 $0$ で充電を開始した時刻」に置き換えて管理します.時刻 $t$ に残量 $w$ のバッテリーを追加したとするとき,このバッテリーは時刻 $t-w$ に残量 $0$ で充電を開始したと考えることが出来ます.したがって,各バッテリーごとに $t-w$ だけを管理すればよいと分かります.こういうものの管理は heapq や,SortedList が得意です.
from sortedcontainers import SortedList

Q, V = map(int, input().split())
S = SortedList()
for _ in range(Q):
    q = list(map(int, input().split()))
    if q[0] == 1:
        t, w = q[1], q[2]
        S.add(t - w)
    else:
        t = q[1]
        if not S:
            print(-1)
        else:
            print(min(V, t - S.pop(0)))
E - Sum of Square of Sum
$\lbrace1,2,\ldots,N\rbrace$ の部分集合 $S$ であって,要素数が $K$ 個であるものを考えます.このときのスコアは次のように書けます.
\[\mathrm{Score}=\left(\sum_{i\in S}A_i\right)^2=\sum_{i\in S}A_i^2+2\sum_{\substack{i<j\ i,j\in S}}A_iA_j\]全ての選び方についてスコアを足し合わせるので,$A_i^2$ と $A_iA_j$ がそれぞれ何回登場するかを考えれば良いです.
- ある $A_i^2$ が登場するのは,ボール $i$ を選び,残りの $K-1$ 個を他の $N-1$ 個から選ぶ場合なので,$\binom{N-1}{K-1}$ 回.
- ある組 $i<j$ に対する $A_iA_j$ が登場するのは,ボール $i,j$ を両方選び,残りの $K-2$ 個を他の $N-2$ 個から選ぶ場合なので,$\binom{N-2}{K-2}$ 回.
したがって,答えは \(\binom{N-1}{K-1}\sum_{i=1}^{N}A_i^2+\binom{N-2}{K-2}\left(\left(\sum_{i=1}^{N}A_i\right)^2-\sum_{i=1}^{N}A_i^2\right)\) となります.
N, K = map(int, input().split())
A = list(map(int, input().split()))

# ----- 二項係数の前計算 -----
mod = 998244353
fact = [1] * (N + 1)
for i in range(1, N + 1):
    fact[i] = (fact[i-1] * i) % mod
inv = [1] * (N + 1)
inv[N] = pow(fact[N], -1, mod)
for i in range(N - 1, 0, -1):
    inv[i] = (inv[i+1] * (i+1)) % mod

def comb(n, r):
    if r < 0 or n < r:
        return 0
    return fact[n] * inv[n-r] * inv[r] % mod
# ----------------------------

s, s2 = 0, 0
for a in A:
    s = (s + a) % mod
    s2 = (s2 + a ** 2) % mod

ans = comb(N-1, K-1) * s2 + comb(N-2, K-2) * (s ** 2 - s2)
print(ans % mod)
F - Concat (maximize)
解けませんでした….方針は立っていたのですが上手い実装が見つからず,解説AC.
まず,選んだ $K$ 個の文字列をどの順番で連結するかを考えます.2つの文字列 $a,b$ について,$a+b>b+a$ ならば $a$ を先に置いた方が大きくなるため,この比較によってソートすれば,選んだ文字列から作れる最大の値を得られます.
次に,どの $K$ 個を選ぶかを考えます.基本的には完成する文字列の桁数を最大にしたいので,長さが大きい文字列から選ぶのが最善です.そこで,$(\mathrm{len}(S_i),\mathrm{int}(S_i))$ の降順にソートし,先頭 $K$ 個を選んだものを候補 $X$ とします.ここで,$X$ の要素のうち $1$ 文字目が 0 でないものが存在するならば,適当に並び替えることで文字列の先頭を 0 以外にできるため,これを最大にする $X$ が最善です.
逆に,$X$ のどの要素も1文字目が 0 である場合は単純に文字列の長さの総和だけでは比較できないため,長さをできるだけ保つために先頭 $K-1$ 個はそのまま選び,残りの1個については $S[K-1:]$ の中から整数として最も大きいものを選べばよいです.これを候補 $Y$ とします.
あとは適切に $X, Y$ を並び替えてどちらが大きいかを調べればよいです.
from functools import cmp_to_key

N, K = map(int, input().split())
S = [input() for _ in range(N)]

def cmp(a, b):
    if a + b > b + a:
        return -1
    if a + b < b + a:
        return 1
    return 0

S.sort(key=lambda s:(len(s), int(s)), reverse=True)

X = S[:K]
Y = S[:K-1] + [max(S[K-1:], key=lambda s:int(s))]

X.sort(key=cmp_to_key(cmp))
Y.sort(key=cmp_to_key(cmp))

x = ''.join(X).lstrip('0')
y = ''.join(Y).lstrip('0')

if not x: x = '0'
if not y: y = '0'

if len(x) != len(y):
    print(x if len(x) > len(y) else y)
else:
    print(max(x, y))